
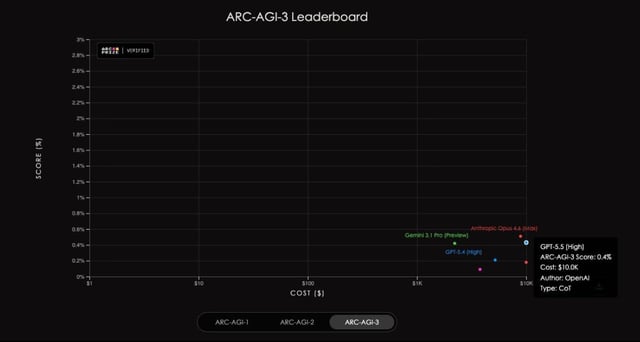
Opublikowano wyniki testów modeli sztucznej inteligencji GPT-5.5 i Opus 4.7 na benchmarku ARC-AGI-3, uzyskując odpowiednio 0,43% i 0,18% skuteczności. Benchmark ARC-AGI-3 pozostaje znaczącym wyzwaniem dla współczesnych modeli AI.
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google