
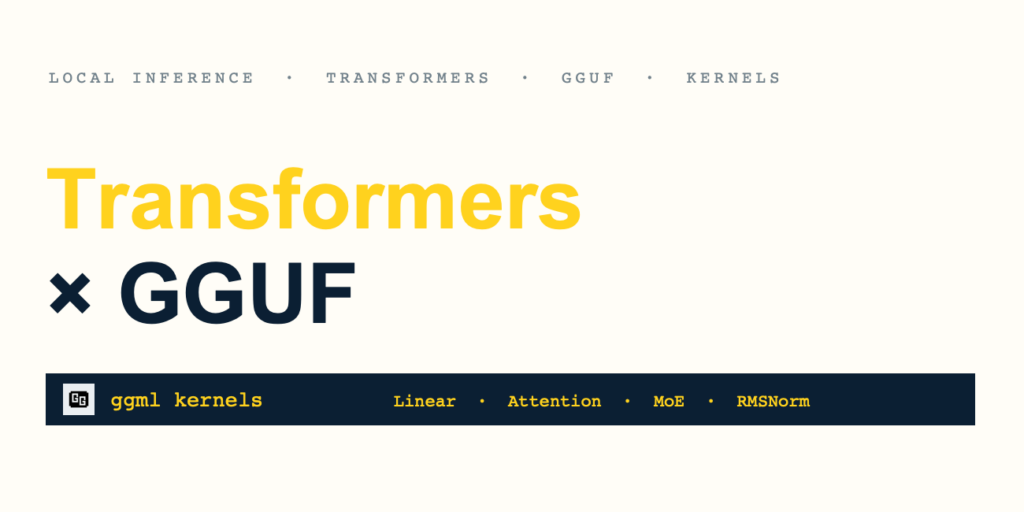
Biblioteka Transformers od Hugging Face zyskała wsparcie dla kwantyzacji w formacie GGUF używanym przez llama.cpp, co ułatwia uruchamianie skompresowanych modeli językowych.
Hugging Face właśnie zrobiło coś, co fani lokalnych modeli językowych przyjmą z radością: biblioteka Transformers nauczyła się rozmawiać językiem llama.cpp. Oznacza to, że skompresowane modele w formacie GGUF, do tej pory zarezerwowane dla osobnego ekosystemu, wchodzą teraz pod jeden dach z resztą narzędzi. Mniej żonglowania plikami, mniej konfiguracyjnych puzzli, więcej czasu na faktyczne eksperymenty.
Ale zanim odkorkowujemy szampana: integracja to jedno, a jakość działania to drugie. Warto zapytać, czy uruchamianie skwantyzowanych modeli przez warstwę Transformers nie doda niepotrzebnego narzutu, który zniweczy właśnie te zyski wydajnościowe, dla których kwantyzacja w ogóle istnieje.
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google