
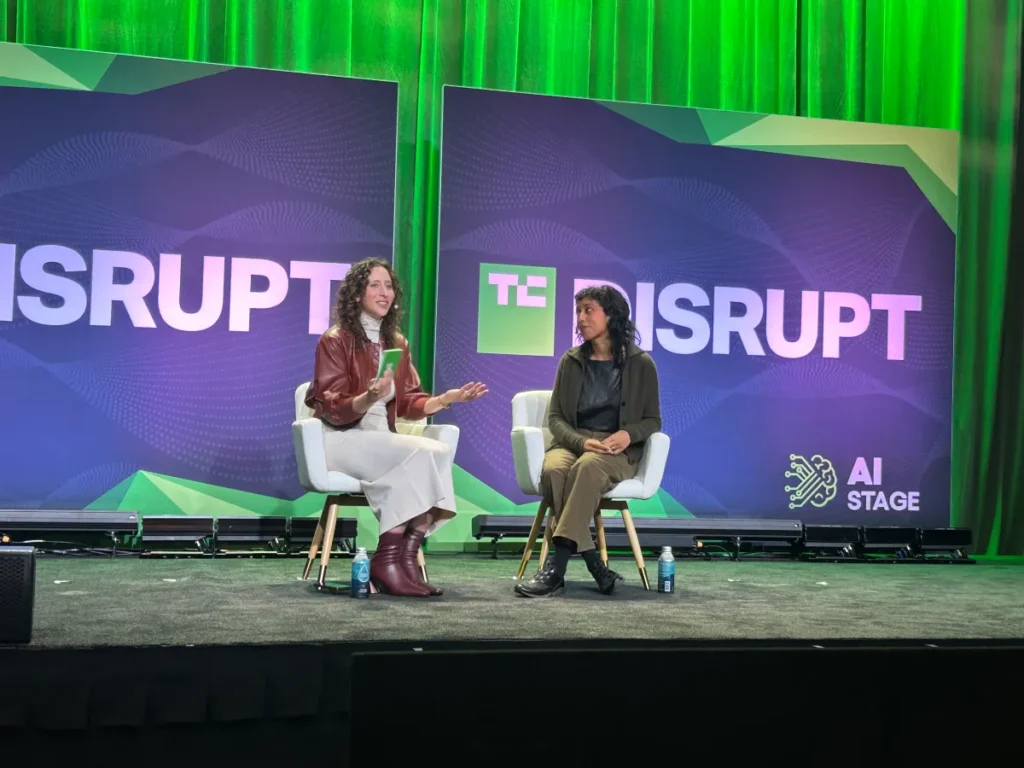
Irene Solaiman, dyrektorka ds. polityki w Hugging Face, ostrzega że metody benchmarkingu modeli AI są skomplikowane i wciąż niedojrzałe, mimo że laboratoria AI opierają na nich swoją reputację. Systemy oceny AI wymagają znacznie większej uwagi i doskonalenia.
Benchmarki AI to dziś coś w rodzaju szkolnych świadectw dla modeli językowych: laboratoria chwalą się wynikami, media podchwytu ją narrację, a my, użytkownicy, wierzymy, że liczby mówią prawdę. Irene Solaiman z Hugging Face rzuca zimną wodę na tę układankę, ostrzegając wprost, że metody ewaluacji są wciąż niedojrzałe i wymagają poważnej pracy.
Pytanie, które zostaje w głowie, jest niewygodne: jeśli narzędzia do oceniania AI są tak zawodne, to na jakiej właściwie podstawie ufamy rankingom, które decydują o reputacji (i miliardowych wycenach) całych laboratoriów?
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google