utworzone przez Redakcja | maj 3, 2026
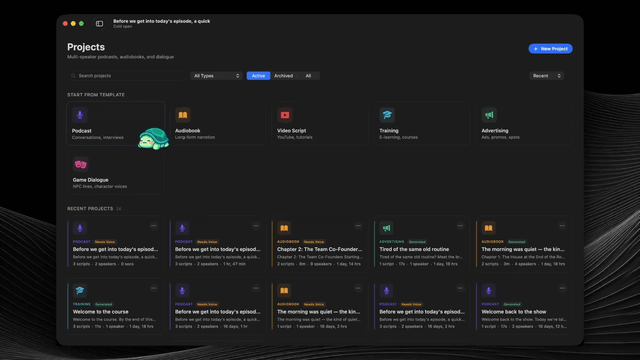
Eksperci wskazują, że głównym wyzwaniem narzędzi AI do generowania głosu nie jest jakość modeli, lecz brak efektywnego workflow do tworzenia dłuższych treści. Generowanie krótkich nagrań jest proste, ale orchestracja złożonych projektów jak podcasty czy audiobooki...
utworzone przez Redakcja | kwi 16, 2026
Google DeepMind wprowadził nowy model audio Gemini 3.1 Flash TTS, który wykorzystuje granularne znaczniki audio umożliwiające zaawansowaną i ekspresywną generację mowy sztucznej inteligencji. Model oferuje użytkownikom precyzyjną kontrolę nad jakością i charakterem...
