utworzone przez Redakcja | paź 7, 2026
Badacze proponują FEM-ASM – organizację modeli językowych, w której pamięć dokumentów i deterministyczne umiejętności wykonawcze współtworzą wspólny stan modelu. Eksperymenty pokazują możliwości, ale też ograniczenia tego podejścia wobec klasycznych...
utworzone przez Redakcja | paź 7, 2026
Microsoft udostępnił w przedsprzedaży komputer deweloperski Surface RTX Spark Dev Box oparty na platformie Nvidia RTX Spark z 128 GB pamięci unified i rdzeniami Tensor. Urządzenie za ok. 6000 dolarów trafi do klientów w listopadzie i jest przeznaczone do lokalnego...
utworzone przez Redakcja | paź 7, 2026
Naukowcy stworzyli SkillScriptBench – zestaw 350 zadań do oceny zdolności agentów LLM do samodzielnego naprawiania i ulepszania pakietów umiejętności łączących instrukcje i skrypty. Benchmark wyróżnia naprawę dokumentacji, naprawę skryptów i zachowanie poprawnego...
utworzone przez Redakcja | paź 6, 2026
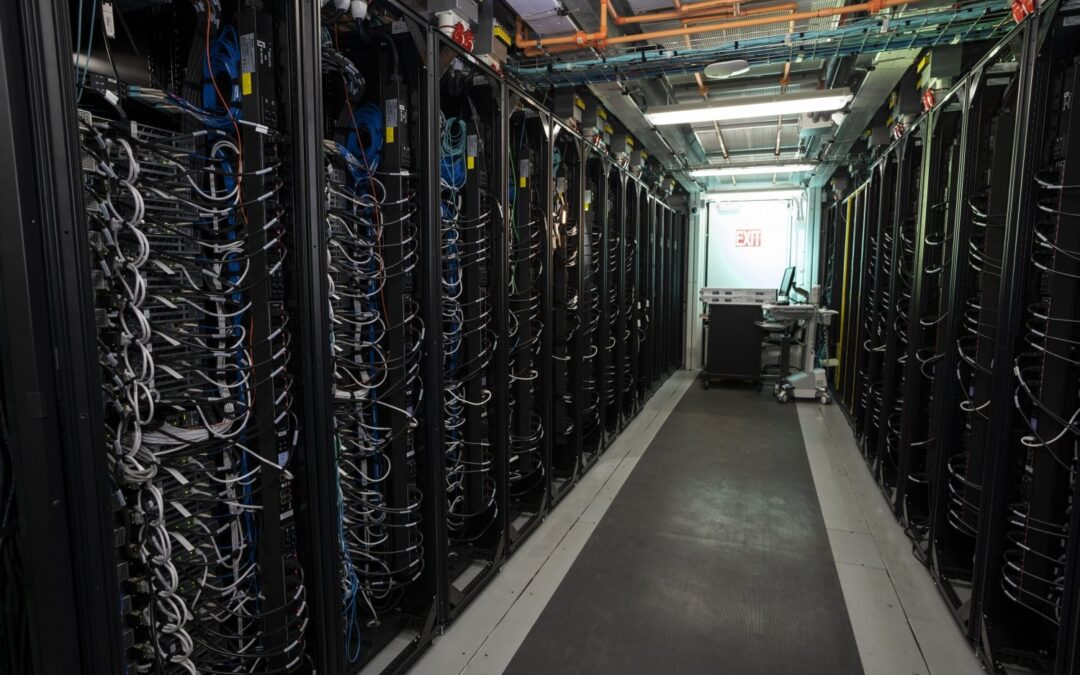
Zespół z Lincoln Laboratory Supercomputing Center od 2018 roku prowadzi coroczne badanie LAICS, analizując komercyjne akceleratory AI i porównując ich szczytową wydajność oraz zużycie energii. Wyniki mają kluczowe znaczenie dla utrzymania przewagi technologicznej...
utworzone przez Redakcja | paź 6, 2026
Badacze analizują trzy kluczowe zachowania autonomicznych agentów kodujących: różnorodność lokalizacji, różnorodność edycji i weryfikację poprawności. Argumentują, że te cechy można nauczyć, zamiast polegać wyłącznie na skalowaniu modeli.
