
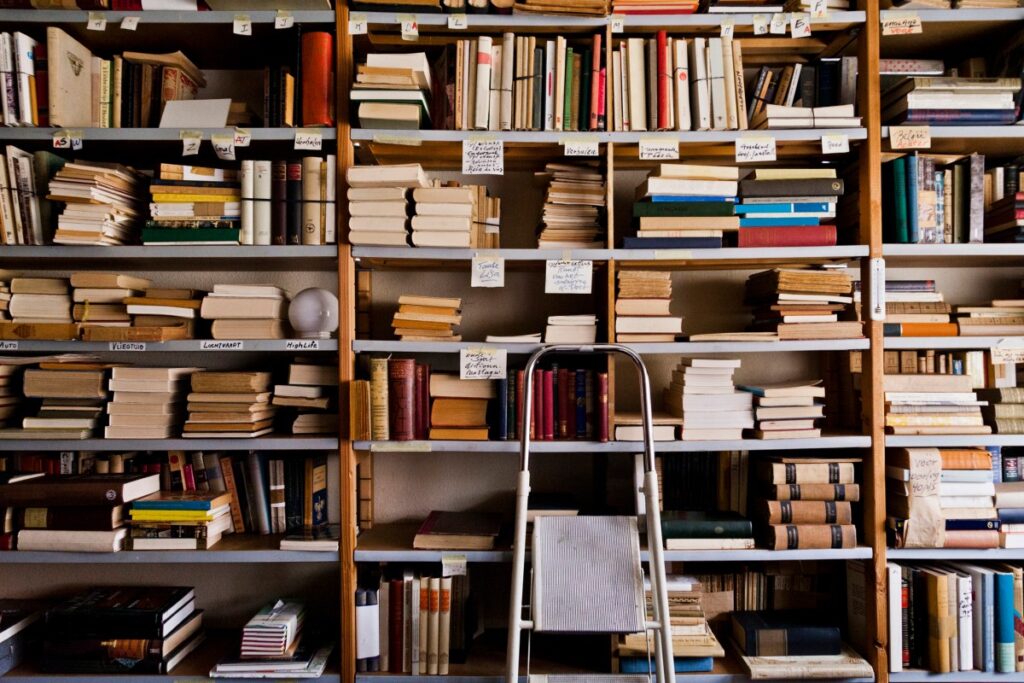
Amazon wykorzystuje rzadkie i unikalne książki jako dane treningowe dla modeli językowych AI, co prowadzi do ich zniszczenia. Rzadkie teksty są szczególnie cenne dla LLM, ponieważ modele wyczerpały już zasoby dostępne w internecie.
Wyobraź sobie, że skaner w bibliotece nie tylko kopiuje książkę, ale ją przy okazji pochłania. Właśnie tak działa najnowszy ruch Amazona: gigant sięga po rzadkie, unikalne woluminy jako paliwo dla swoich modeli językowych, bo zwykłe zasoby internetu przestały już wystarczać głodnym danym algorytmom.
Brzmi jak cyfrowy postęp, ale zostaje po nim nieprzyjemny posmak: czy naprawdę musimy niszczyć nieodwracalne dziedzictwo kulturowe, żeby nauczyć maszynę lepiej pisać maile? To pytanie, na które Amazon raczej nie spieszy się z odpowiedzią.
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google