
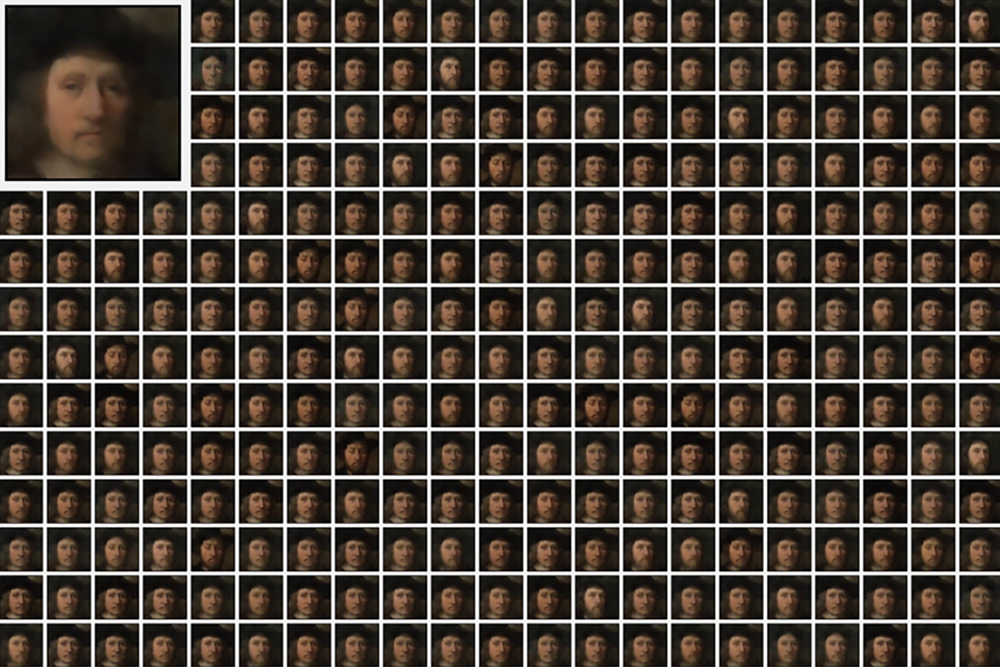
Naukowcy z MIT CSAIL odkryli zjawisko zwane 'rozpadem atrybucji' – im więcej danych treningowych użyto do nauki modelu generatywnego, tym trudniej powiązać konkretny wynik z konkretnym dziełem źródłowym. Odkrycie komplikuje prawne i etyczne rozstrzygnięcia dotyczące praw autorskich w AI.
Naukowcy z MIT CSAIL odkryli coś, co brzmi jak kłopot dla całej branży: im więcej danych pochłonie model generatywny, tym bardziej jego wyniki przypominają zupę, w której nie sposób wyłowić konkretnego składnika. To zjawisko, nazwane "rozpadem atrybucji", działa jak artystyczny odcisk palca rozpuszczony w oceanie miliardów obrazów.
Brzmi jak eleganckie rozwiązanie sporów o prawa autorskie? Wręcz przeciwnie: jeśli nie można udowodnić, że model "pożyczył" od konkretnego twórcy, to równie trudno będzie twórcy udowodnić, że został skrzywdzony, a to oznacza, że prawo może tu stać bezradnie z rękami w kieszeniach.
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google