
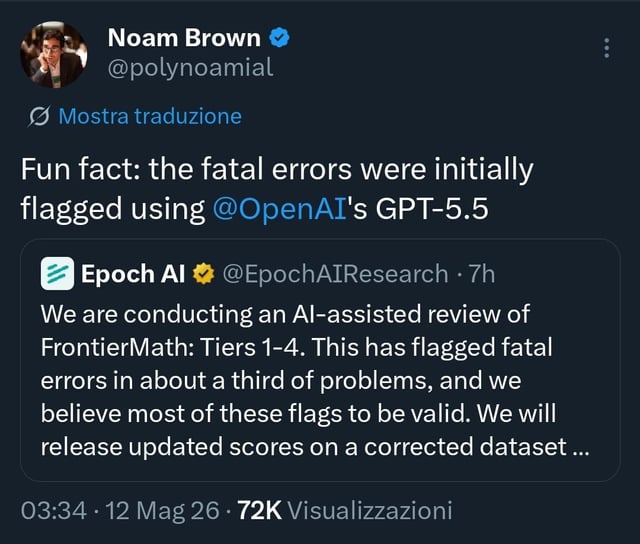
Model GPT-5.5 został wykorzystany do weryfikacji testu FrontierMath i odkrył poważne błędy w około trzeciej części zadań. Incydent pokazuje, że modele AI stały się już na tyle zaawansowane, że mogą sprawdzać poprawność własnych benchmark'ów.
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google