utworzone przez Redakcja | maj 12, 2026
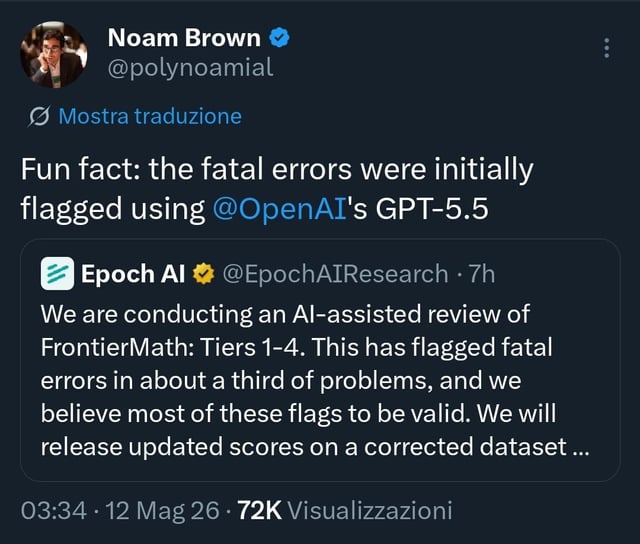
Model GPT-5.5 został wykorzystany do weryfikacji testu FrontierMath i odkrył poważne błędy w około trzeciej części zadań. Incydent pokazuje, że modele AI stały się już na tyle zaawansowane, że mogą sprawdzać poprawność własnych...
utworzone przez Redakcja | kwi 16, 2026
OpenAI nabyła dostęp do platformy FrontierMath, która pozwala weryfikować rozwiązania generowane przez modele sztucznej inteligencji. To narzędzie ma wspierać walidację i sprawdzanie poprawności odpowiedzi AI.
