
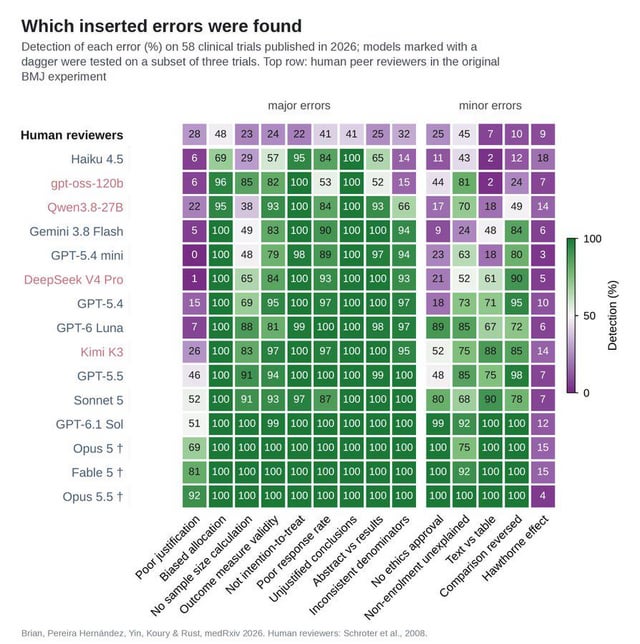
Duże modele językowe okazują się znacznie skuteczniejsze od wyszkolonych recenzentów w znajdowaniu błędów w artykułach naukowych. To odkrycie może zrewolucjonizować proces recenzji naukowej.
Wyobraź sobie, że latami szkolisz się jako recenzent naukowy, a potem przychodzi algorytm i robi to lepiej od ciebie, szybciej i bez kawy o trzeciej w nocy. Właśnie taką rewolucję zwiastują najnowsze badania: duże modele językowe okazują się znacznie skuteczniejsze od wyszkolonych ekspertów w tropieniu błędów w publikacjach naukowych, co mogłoby gruntownie przeorać cały system peer review.
Zanim jednak zaczniemy żegnać ludzkich recenzentów, warto zadać kluczowe pytanie: kto sprawdzi, czy sam model nie myli się w sprawach, których po prostu nie rozumie, a jedynie przekonująco udaje, że rozumie?
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google