
utworzone przez Redakcja | maj 2, 2026
Model GPT 5.5 wykazał najlepsze wyniki w prywatnym benchmarku Kaggle polegającym na odgadnięciu dokładnego tytułu artykułu naukowego na podstawie jego streszczenia. Test stanowi efektywny wskaźnik zdolności modelu do prawidłowego przypisywania twierdzeń naukowych ich...

utworzone przez Redakcja | maj 2, 2026
Handlowcy na rynkach predykcji zauważyli lukę między najlepszym dostępnym modelem AI a tym, który rzeczywiście mogą używać. Po wydaniu GPT-5.5 spekulanci chwilowo wycenili konkurencyjną odpowiedź Anthropic, ale jej nie było.
utworzone przez Redakcja | maj 2, 2026
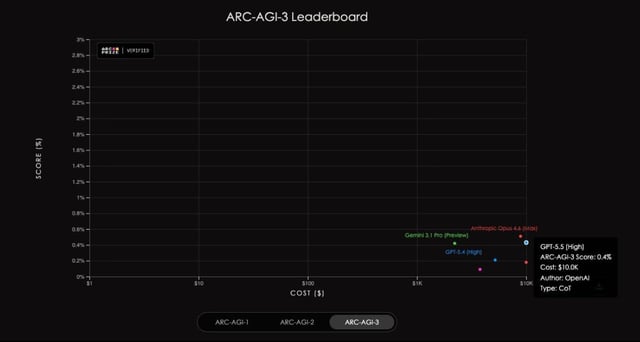
Opublikowano wyniki testów modeli sztucznej inteligencji GPT-5.5 i Opus 4.7 na benchmarku ARC-AGI-3, uzyskując odpowiednio 0,43% i 0,18% skuteczności. Benchmark ARC-AGI-3 pozostaje znaczącym wyzwaniem dla współczesnych modeli AI.

utworzone przez Redakcja | kwi 30, 2026
OpenAI wprowadza narzędzie do testowania bezpieczeństwa cybernetycznego GPT-5.5 Cyber, ale inicjalnie udostępnia je wyłącznie kluczowym obrońcom cyberbezpieczeństwa. Decyzja stanowi podobne podejście do ograniczeń zastosowanych wcześniej przez...

utworzone przez Redakcja | kwi 30, 2026
Model GPT-5.5 rozwiązał zadanie cyberbezpieczeństwa w 11 minut za 1,73 dolara, które ekspertowi zajęło 12 godzin. Test przeprowadzony przez brytyjskie instytucje bezpieczeństwa wykazał zaawansowane możliwości modelu w atakach wieloetapowych.
