utworzone przez Redakcja | lis 5, 2026
HuggingFace zaprezentował Phonon TTS – model syntezy mowy działający lokalnie na urządzeniu, który osiąga wyniki przewyższające dotychczasowe benchmarki w dziedzinie jakości generowanej mowy.
utworzone przez Redakcja | paź 24, 2026
Block zaprezentował nowy model głosowy, który według firmy brzmi wyjątkowo naturalnie. Model może działać lokalnie na MacBooku M4 Max bez potrzeby połączenia z chmurą.
utworzone przez Redakcja | paź 2, 2026
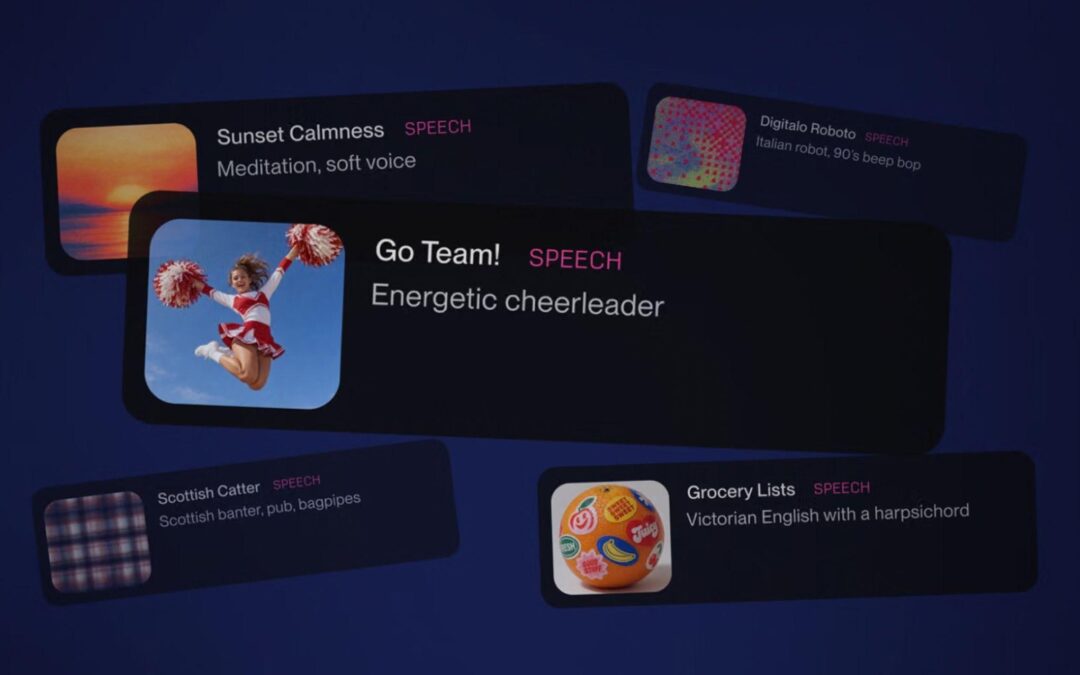
Platforma do tworzenia muzyki AI, Suno, uruchomiła funkcję Speech w publicznej becie, która generuje lektora na podstawie skryptu lub opisu i łączy go z podkładem muzycznym. To pierwszy model audio firmy łączący głos i muzykę w jednym narzędziu.
utworzone przez Redakcja | maj 28, 2026
ElevenLabs uruchomił Dubbing v2, narzędzie do automatycznego dubbingu, które zachowuje emocje i ton głosu oryginału podczas tłumaczenia na inne języki.
utworzone przez Redakcja | maj 14, 2026
Developer udostępnił pierwsze wydanie wtyczki Comfy UI dla narzędzia DramaBox do syntezy mowy. Dodatek automatycznie pobiera modele i wymaga tylko węzła TTS do podstawowego działania.
