utworzone przez Redakcja | paź 29, 2026
Badacze przedstawili BehaveRec – system rekomendacji łączący trzy sygnały: sesję użytkownika, 90-dniową historię zachowań oraz graf społecznościowy oparty na podobieństwie embeddingów. Na zbiorze 137M sekwencji od 12,6M użytkowników model poprawił wynik R@5 o 3,2%...
utworzone przez Redakcja | wrz 21, 2026
Badacze zaproponowali metodę AAR, która ulepsza routing w modelach językowych Mixture-of-Experts poprzez wykorzystanie cech czasowych i spektralnych z mechanizmu uwagi. Podejście poprawia wyniki na benchmarku GSM8K o 3,37 punktu procentowego przy zamrożonych...

utworzone przez Redakcja | sie 25, 2026
KVBoost to system wielokrotnego użycia pamięci podręcznej klucz-wartość dla dużych modeli językowych, który działa niezależnie od pozycji współdzielonej treści w prompcie. Dzięki podwójnemu schematowi hashowania redukuje opóźnienia prefill bez ograniczeń tradycyjnych...
utworzone przez Redakcja | cze 20, 2026
Badacze przedstawili ITNet – sieć neuronową opartą na uczonym przekształceniu całkowym, która matematycznie ujednolica sploty, rekurencję i mechanizmy uwagi. Architektura wykorzystuje małą sieć MLP do modelowania interakcji parami, zastępując dotychczas odrębne...
utworzone przez Redakcja | maj 25, 2026
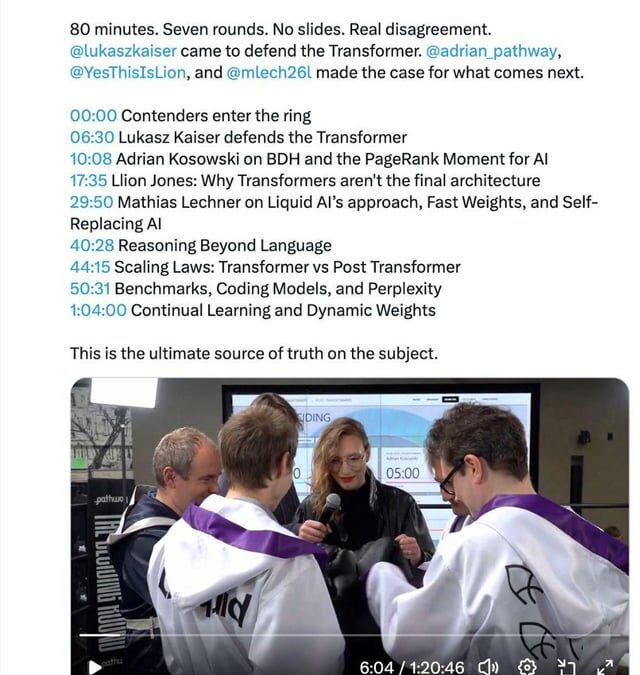
Jeden z autorów przełomowego artykułu o transformerach argumentuje, że należy wyjść poza ten model. Debata Pathway'a na ten temat zasługuje na uwagę.
