utworzone przez Redakcja | maj 25, 2026
Naukowcy udowodnili, że architektura modeli językowych ma wbudowany limit dokładności, który nie może być przekroczony niezależnie od treningu. Odkrycie to może być obliczane przed wdrożeniem systemu na podstawie liczby warstw i szerokości osadzania.
utworzone przez Redakcja | maj 17, 2026
Naukowiec zbadał możliwość routing'u aktywacji transformera przez skompresowaną sieć E8 i odkrył ostrą granicę stabilności generacyjnej. Przekroczenie współczynnika blendu β=0.20 powoduje załamanie modelu i pętle semantyczne.
utworzone przez Redakcja | maj 16, 2026
Naukowcy wprowadzili Conditional Attribute Transformers – innowacyjną metodę pozwalającą na jednoczesne przewidywanie następnego tokena i oszacowanie atrybutów sekwencji w jednym przebiegu sieci. Rozwiązanie eliminuje potrzebę kosztownego samplingowania i modyfikacji...
utworzone przez Redakcja | maj 11, 2026
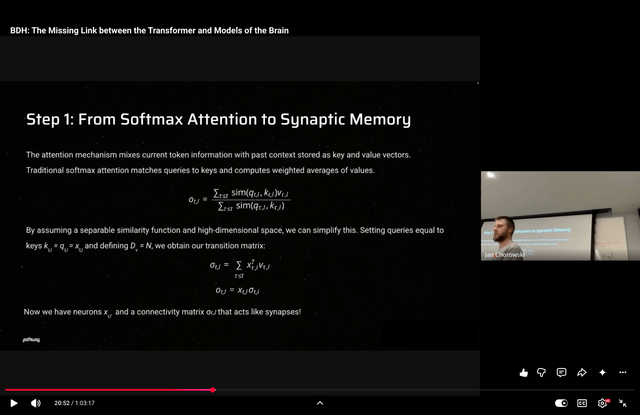
Artykuł analizuje architekturę BDH, która proponuje przechowywanie pamięci modeli językowych w wagach sieci neuronowej zamiast w rosnącym buforze KV cache. Autor porównuje pamięć transformerów do anterograde amnezji, gdzie długoterminowa pamięć jest kompresowana w...
utworzone przez Redakcja | maj 5, 2026
Startup Subquadratic zaprezentował nowy model języka SubQ wyposażony w mechanizm sparse attention, umożliwiający obsługę kontekstu 12 milionów tokenów. Technologia pozwala na efektywniejsze przetwarzanie dużych ilości tekstu przy zmniejszonym zużyciu...
