utworzone przez Redakcja | paź 21, 2026
Naukowcy opracowali metodę wykorzystującą duże modele językowe i wielocelowe uczenie ze wzmocnieniem do generowania układów RTL spełniających różne kompromisy między poborem mocy, wydajnością i powierzchnią układu. Podejście pozwala projektantom wybierać spośród...
utworzone przez Redakcja | paź 7, 2026
Badacze przedstawili Exploration-Preserving Policy Optimization (ExPPO) – lekką metodę kształtowania przewagi w uczeniu ze wzmocnieniem, która redystrybuuje kredyt uczenia z wykorzystaniem zaskoczenia odpowiedzi i współczynnika powodzenia promptu. Metoda ma na celu...
utworzone przez Redakcja | wrz 18, 2026
Naukowcy wprowadzili metodę RETD (Regularized Emphatic TD), która rozwiązuje problem niestabilności próbkowanej dynamiki w uczeniu ze wzmocnieniem off-policy, zachowując właściwości oryginalnego algorytmu ETD przy stałym kroku uczenia.
utworzone przez Redakcja | wrz 16, 2026
Naukowcy opracowali framework TimeThink, który poprawia zdolność multimodalnych modeli językowych do rozumowania nad szeregami czasowymi. System ma szczególne znaczenie dla zastosowań wysokiego ryzyka, takich jak opieka zdrowotna.
utworzone przez Redakcja | lip 22, 2026
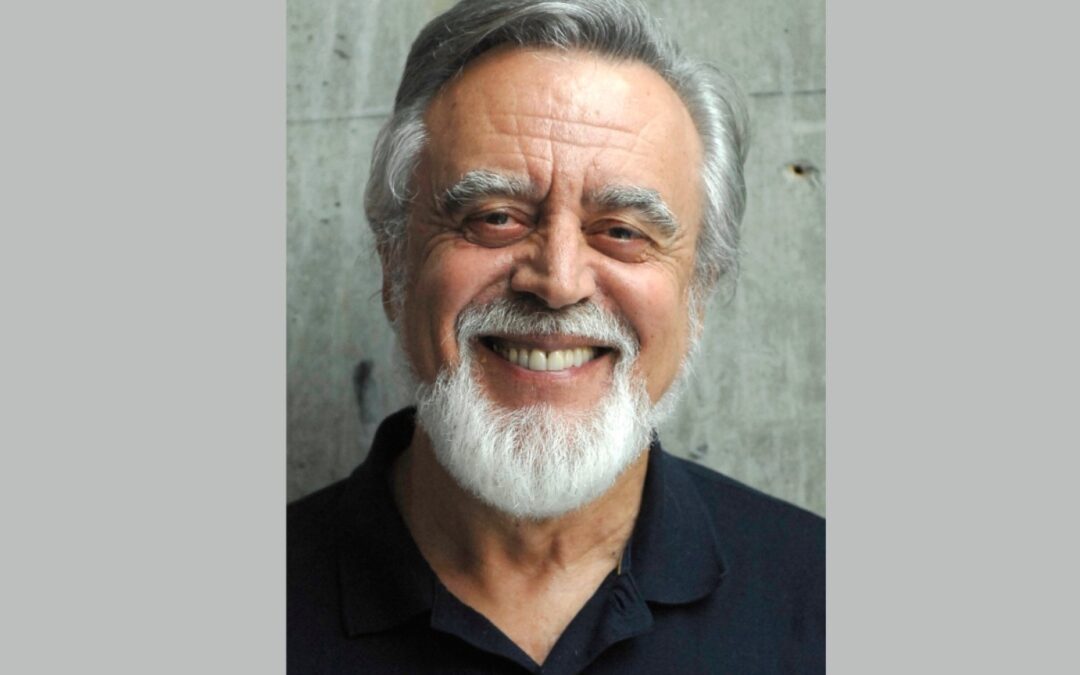
Dimitri Bertsekas, emerytowany profesor MIT i jeden z najbardziej wpływowych naukowców w dziedzinie optymalizacji, uczenia ze wzmocnieniem i sztucznej inteligencji, zmarł 3 czerwca w wieku 83 lat. Jego prace miały przełomowy wpływ na współczesne metody AI i obliczenia...
