
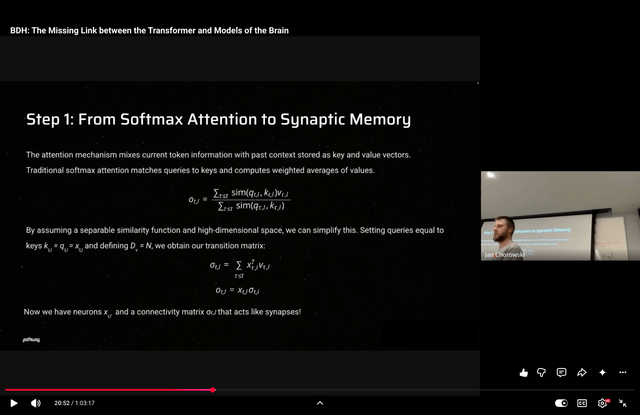
Artykuł analizuje architekturę BDH, która proponuje przechowywanie pamięci modeli językowych w wagach sieci neuronowej zamiast w rosnącym buforze KV cache. Autor porównuje pamięć transformerów do anterograde amnezji, gdzie długoterminowa pamięć jest kompresowana w wagach, a krótkoterminowa w bieżącej sesji.
To streszczenie zostało przygotowane przy pomocy narzędzi AI na podstawie źródła. Pełną treść znajdziesz w oryginalnym artykule.
Co o tym myślisz?
Zaloguj się, aby dołączyć do dyskusji.
Zaloguj się do dzis.ai
Komentuj, zachowaj swoją passę, dołącz do dyskusji.
G Kontynuuj z Google