utworzone przez Redakcja | maj 13, 2026
Naukowcy opracowali nowe standardy i benchmarki do oceny zdolności modeli LLM do wykrywania halucynacji – fikcyjnych lub niespójnych treści generowanych przez sztuczną inteligencję. Wykazali, że istniejące benchmarki nie spełniają wszystkich kluczowych...

utworzone przez Redakcja | maj 12, 2026
Naukowcy opracowują nowe metody benchmarkingu dla modeli AI używanych w klinikach, skupiając się na niezawodności i bezpieczeństwie w rzeczywistych warunkach medycznych, a nie tylko na samej wydajności.
utworzone przez Redakcja | maj 12, 2026
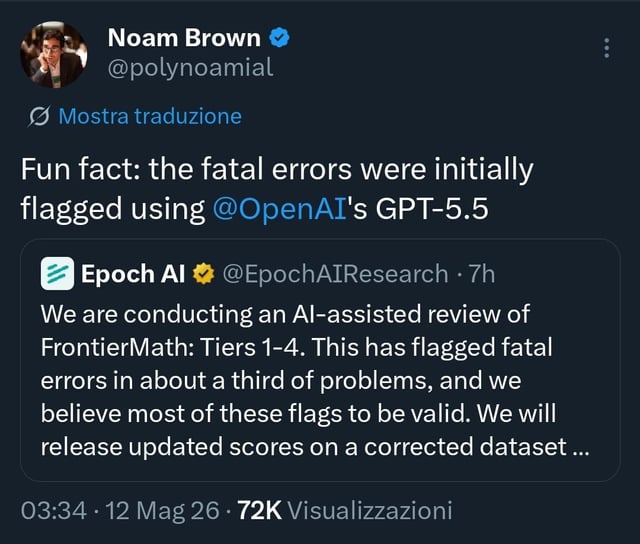
Model GPT-5.5 został wykorzystany do weryfikacji testu FrontierMath i odkrył poważne błędy w około trzeciej części zadań. Incydent pokazuje, że modele AI stały się już na tyle zaawansowane, że mogą sprawdzać poprawność własnych...

utworzone przez Redakcja | maj 12, 2026
Artificial Analysis wprowadził indeks do oceny agentów kodujących, zawierający trzy benchmarki obejmujące realistyczne zadania programistyczne, zadania terminalowe i pytania techniczne dotyczące zachowania kodu.

utworzone przez Redakcja | maj 11, 2026
Nowy test PACT ocenia umiejętności negocjacyjne dużych modeli językowych w 20-rundowej grze kupca-sprzedawcy. W rankingu prowadzą GPT-5.5, Opus 4.7 i DeepSeek V4 Pro.
