
utworzone przez Redakcja | maj 2, 2026
Model GPT 5.5 wykazał najlepsze wyniki w prywatnym benchmarku Kaggle polegającym na odgadnięciu dokładnego tytułu artykułu naukowego na podstawie jego streszczenia. Test stanowi efektywny wskaźnik zdolności modelu do prawidłowego przypisywania twierdzeń naukowych ich...

utworzone przez Redakcja | maj 2, 2026
Nowy benchmark mierzy wydajność operacji atencji na GPU, kluczowego wąskiego gardła w modelach generatywnych. Test wykorzystuje rzeczywiste kształty tensorów z modeli obrazu, wideo i audio.
utworzone przez Redakcja | maj 2, 2026
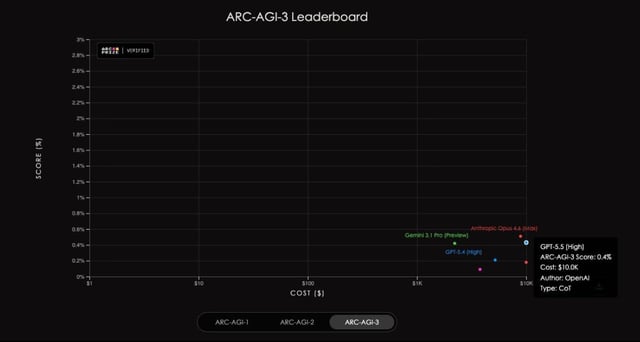
Opublikowano wyniki testów modeli sztucznej inteligencji GPT-5.5 i Opus 4.7 na benchmarku ARC-AGI-3, uzyskując odpowiednio 0,43% i 0,18% skuteczności. Benchmark ARC-AGI-3 pozostaje znaczącym wyzwaniem dla współczesnych modeli AI.
utworzone przez Redakcja | kwi 27, 2026
Naukowcy z arXiv zaproponowali nowy benchmark oceniający zdolność modeli językowych do konstruowania pojęć matematycznych przez komunikację. Test bada, czy sztuczna inteligencja posiada autentyczne rozumowanie matematyczne, czy tylko dopasowuje wzorce...

utworzone przez Redakcja | kwi 25, 2026
Naukowcy przedstawili MMTR-Bench, nowy benchmark do testowania umiejętności multimodalnych modeli językowych w rekonstruowaniu maskowanego tekstu bezpośrednio z kontekstu wizualnego, bez jawnych instrukcji.
